Actualite · Agents IA
OpenAI Agents API : construire des agents sans gerer l'orchestration soi-meme
17 septembre 2026 · 6 min de lecture
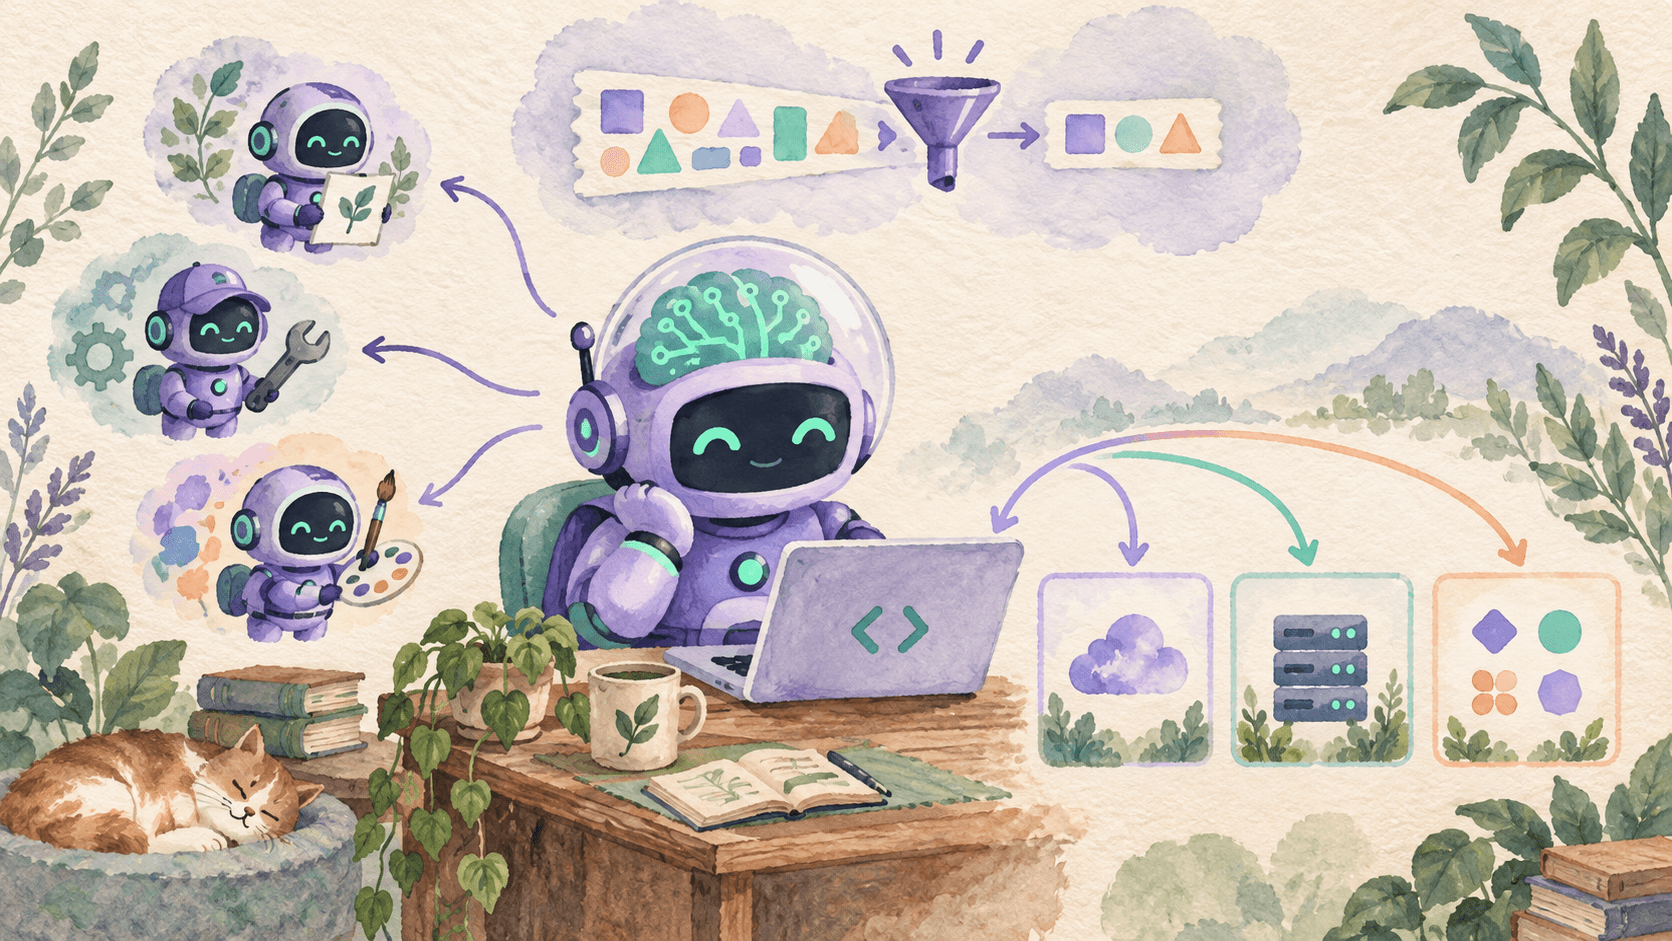
OpenAI a ouvert l'Agents API le 10 septembre 2026, en bêta publique. C'est l'infrastructure qui fait tourner Codex, leur agent de code, et elle est maintenant accessible aux développeurs via une API. Une seule phrase pour résumer : tu choisis un modèle, des outils et un environnement, et OpenAI gère l'orchestration, la mémoire et la récupération après erreur.
C'est un changement de niveau d'abstraction. Avant, si tu voulais construire un agent qui tourne plusieurs heures, qui garde le contexte entre les étapes et qui délègue des sous-tâches à d'autres agents, tu devais coder tout ça toi-même. La gestion du context window, la compaction quand la mémoire déborde, l'orchestration de subagents en parallèle, la reprise après crash : c'était ton boulot. L'Agents API prend tout ça en charge.
Ce que l'API fait, concretement
Quatre concepts : Agent, Environment, Session, Events.
L'agent, c'est le modèle plus les instructions plus les outils. Tu choisis ton modèle (la doc utilise gpt-6-astra dans ses exemples), tu donnes des instructions, tu branches des outils. Les outils supportés : MCP (Model Context Protocol), fonctions custom, outils intégrés comme la recherche web.
L'environnement, c'est la ou l'agent travaille. Trois options : une sandbox hébergée par OpenAI, ta propre infrastructure (self-hosted), ou une sandbox chez un partenaire. Neuf partenaires au lancement : Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop, Vercel.
La session, c'est l'instance durable. Tu crées une session, tu lui donnes une tâche, elle tourne. Tu peux la suivre en streaming ou via webhooks. Tu peux lui envoyer des instructions supplémentaires pendant qu'elle travaille, ou la reprendre là où elle s'est arrêtée.
Les events, c'est ce qui entre et sort. Input de ta part, output de l'agent, appels d'outils, résultats. C'est le protocole de communication.
Ce que le harness gere pour toi
Le Codex harness, c'est le code open source qui orchestre tout ça. Il est sur GitHub (github.com/openai/codex). L'Agents API, c'est ce même harness, mais opéré et maintenu par OpenAI comme un service managé.
Trois fonctionnalités qui comptent pour les agents longue durée :
La compaction de contexte. Quand une session approche de sa limite de contexte, le harness résume automatiquement le contexte antérieur pour faire de la place. Tu n'as pas besoin d'écrire ta propre logique de compaction. C'est ce qui permet à un agent de travailler pendant des heures sans perdre le fil, même si le contexte total dépasse ce que le modèle peut ingérer en une fois.
Le tool search et le programmatic tool calling. Si tu branches beaucoup d'outils (des dizaines de fonctions, plusieurs serveurs MCP), le harness ne charge que les définitions d'outils pertinentes pour l'étape en cours. Ça réduit la consommation de tokens et préserve le cache. Une fois les outils disponibles, le programmatic tool calling laisse l'agent exécuter des appels en parallèle, chaîner des opérations et filtrer les résultats dans du code avant de les ramener dans le contexte. Concrètement : l'agent peut faire dix appels d'API, garder les trois résultats pertinents, et ne remonter que ceux-là.
Les subagents. Le harness peut découper une tâche complexe en morceaux indépendants et les déléguer à des subagents qui tournent en parallèle. Chaque subagent a son propre contexte, ce qui l'aide à rester focalisé sur sa partie. L'agent principal coordonne et assemble les résultats. Tu configures ça avec un paramètre : multi_agent: { enabled: true, max_concurrent_subagents: 4 }. Pas besoin de construire ton propre orchestrateur.
Le prix
Pas de frais supplémentaire pour l'Agents API elle-même. Tu paies les tokens du modèle au tarif normal, les outils intégrés (comme la recherche web) à leur tarif standard, et la sandbox hébergée au tarif container. Si tu choisis self-hosted, tu paies ton infrastructure de ton côté.
Un exemple chez Maisons&Mobilia
Antoine, lead developer chez Maisons&Mobilia (M&M, enseigne de meubles fictive), veut automatiser la revue de tickets de support. Son équipe reçoit 2 000 tickets par semaine. Aujourd'hui, un agent custom lit chaque ticket, le classifie, cherche dans la base de connaissances, et propose une réponse. Antoine a codé l'orchestration lui-même : la gestion du contexte, les retries, le routing entre les différents outils. Ça marche, mais ça demande de la maintenance. Le code d'orchestration fait 3 000 lignes et personne dans l'équipe n'aime y toucher.
Avec l'Agents API, Antoine crée une session avec gpt-6-astra, branche un serveur MCP qui expose la base de connaissances, active la recherche web pour les questions hors base, et configure deux subagents : un pour la classification et un pour la recherche de solution. L'agent principal coordonne.
Le code d'orchestration, les 3 000 lignes, disparaissent. Antoine envoie la tâche à la session, récupère les events en streaming, et c'est tout. La compaction de contexte gère les sessions longues. Les subagents tournent en parallèle. Si une session crash, elle reprend là où elle s'est arrêtée.
Ce que Antoine doit quand même faire : définir les outils, écrire les instructions, choisir les bons seuils de confiance, et tester le résultat. L'API gère l'infrastructure, pas la qualité du travail de l'agent. Si l'agent classe mal un ticket, c'est un problème de prompt ou de modèle, pas un problème d'orchestration.
La limite qui le freine : les données de session transitent par les serveurs d'OpenAI, qui sont aux États-Unis. Pour les tickets de support de M&M, qui contiennent parfois des données clients, c'est un point de vigilance RGPD. Antoine teste d'abord sur des tickets anonymisés. Si le workflow fonctionne, il envisage le mode self-hosted pour garder l'exécution en local, même si les données de session passent toujours par l'API.
Ce que ca change si tu apprends l'IA
-
Les agents, c'est pas juste un modèle qui appelle des outils. L'orchestration, la gestion de contexte, la coordination de subagents, la reprise après erreur : c'est une couche d'infrastructure complète. L'Agents API la rend optionnelle, mais comprendre ce qu'elle fait reste nécessaire. Si tu ne sais pas ce que la compaction de contexte fait, tu ne sais pas quand elle peut perdre de l'information importante.
-
MCP (Model Context Protocol) devient un standard. L'Agents API le supporte nativement, comme Claude le fait depuis plusieurs mois. Un serveur MCP expose des outils et des données de façon standardisée, et n'importe quel agent compatible peut s'y brancher. Comprendre MCP, c'est comprendre comment les agents accèdent au monde extérieur.
-
Le choix de l'environnement d'exécution est une décision architecturale. Sandbox OpenAI pour démarrer vite, self-hosted pour le contrôle, partenaire pour les cas intermédiaires. Cette flexibilité est nouvelle : avant, tu gérais tout toi-même ou tu n'avais rien. Maintenant, tu choisis ton niveau d'abstraction.
Aller plus loin
Pour comprendre comment un agent IA utilise des outils et enchaîne des étapes, notre article sur comment fonctionne un agent IA pose les bases du tool use et de l'orchestration. Pour voir les garde-fous à mettre en place quand un agent accède à tes données, le guide sur les garde-fous des agents IA détaille le moindre privilège et le human in the loop. Pour comprendre MCP, notre article sur le Model Context Protocol explique comment les agents se branchent aux données externes. Et pour t'entraîner à ces notions en 5 minutes par jour, l'app saisir.ai propose des modules interactifs sur les modèles, les agents et le déploiement, en français, sans coder.
Sources
- OpenAI, "Introducing the Agents API", 10 septembre 2026
- OpenAI Developers, "Agents API Overview", septembre 2026
- OpenAI, "Codex harness", GitHub repository
- Forkast, "OpenAI Formalizes the Codex Harness as a Managed API", 11 septembre 2026
- Analytics Insight, "OpenAI Agents API: Codex Harness, Features and Architecture", 11 septembre 2026
Questions fréquentes
- C'est quoi l'Agents API d'OpenAI ?
- C'est une API en bêta publique depuis le 10 septembre 2026 qui expose le Codex harness. Tu cree une session avec un modele, des outils et un environnement, et OpenAI gere l'orchestration, la memoire de contexte et la recuperation apres erreur. Pas de frais supplementaire pour l'API : tu paies les tokens, les outils et la sandbox.
- Quel modele faut-il utiliser avec l'Agents API ?
- L'API supporte les modeles d'OpenAI. Les exemples de la doc utilisent gpt-6-astra. Tu choisis le modele au moment de creer la session, comme tu le ferais avec l'API chat completions classique.
- Peut-on heberger l'agent sur sa propre infrastructure ?
- Oui. L'API propose trois options : sandbox hebergee par OpenAI, self-hosted sur ton infrastructure, ou sandbox chez un partenaire (Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop, Vercel). Attention : meme en self-hosted, les donnees de session transitent par les serveurs d'OpenAI, qui sont aux US.
- L'Agents API gere-t-elle le contexte long ?
- Oui. L'API compacte automatiquement le contexte quand la session approche de sa limite. Tu n'as pas besoin d'ecrire ta propre logique de compaction. C'est utile pour les agents qui travaillent plusieurs heures sur un meme sujet.
- L'Agents API convient-elle aux donnees sensibles ?
- Pas pour l'instant. En bêta, la residence des donnees est restreinte aux Etats-Unis, et il n'existe pas d'option Zero Data Retention, meme en self-hosted. Pour les donnees reglementees ou confidentielles, c'est un blocage.